Google 30. září 2026 představil Gemini 4 Argon. Nový model slibuje výkonnější práci s kódem, dokumenty, financemi a kybernetickou obranou. První čísla vypadají silně, ale běžní uživatelé si ho zatím nemohou sami ověřit. Co přesně víme, jak si vede ve srovnání s konkurencí a co má smysl dělat ve firmě už teď?
Stav k 1. říjnu 2026. Jde o hodnocení oznámení, zveřejněných testů a prvních reakcí, nikoli o náš vlastní uživatelský test modelu.
Co Google skutečně uvedl
Plný název oznámeného modelu je Gemini 4 Argon. Google ho zaměřuje na dlouhé, vícekrokové úlohy: vývoj softwaru, odbornou práci ve financích a právu a vyhledávání či opravy bezpečnostních chyb. První přístup získává omezená skupina prověřených obránců v programu Fairwind. Google slibuje pozdější rozšíření k vývojářům, firmám a spotřebitelům; jako první mají přijít na řadu platící zákazníci API a předplatitelé Google AI Ultra. Termín širokého zpřístupnění ale neuvedl. Zdroj: oznámení Googlu.
Google uvádí zaváděcí cenu 2 USD za milion vstupních tokenů a 10 USD za milion výstupních tokenů; po úvodním období má být cena 4 a 20 USD. U vstupů z mezipaměti slibuje slevu 95 %. Jde o oznámené ceny pro budoucí dostupnost, nikoli o potvrzení, že je model už dnes běžně objednatelný. Firma také mluví o limitu až 1 milionu výstupních tokenů oproti dřívějším 64 tisícům. To je strop výstupu, nikoli automatická záruka, že každá dlouhá odpověď bude stejně přesná. Zdroj: Google.
Srovnání: velmi silný výsledek, ale ne univerzální vítěz
Nezávislá hodnoticí platforma Vals AI zařadila Argon na 1. místo ze 41 modelů ve Vals Indexu se skóre 68,90 %. Nejbližší modely v tomto testu byly Claude Sonnet 5.5 (67,04 %), Claude Opus 5.5 (66,97 %) a Claude Fable 5.1 (65,83 %). Rozdíl mezi prvním a druhým místem je 1,86 procentního bodu. Vals zároveň uvádí statistickou nejistotu výsledku Argonu ±0,97 bodu, proto je rozumnější mluvit o těsném vedení než o drtivém náskoku. Zdroj a metodika: Vals AI.
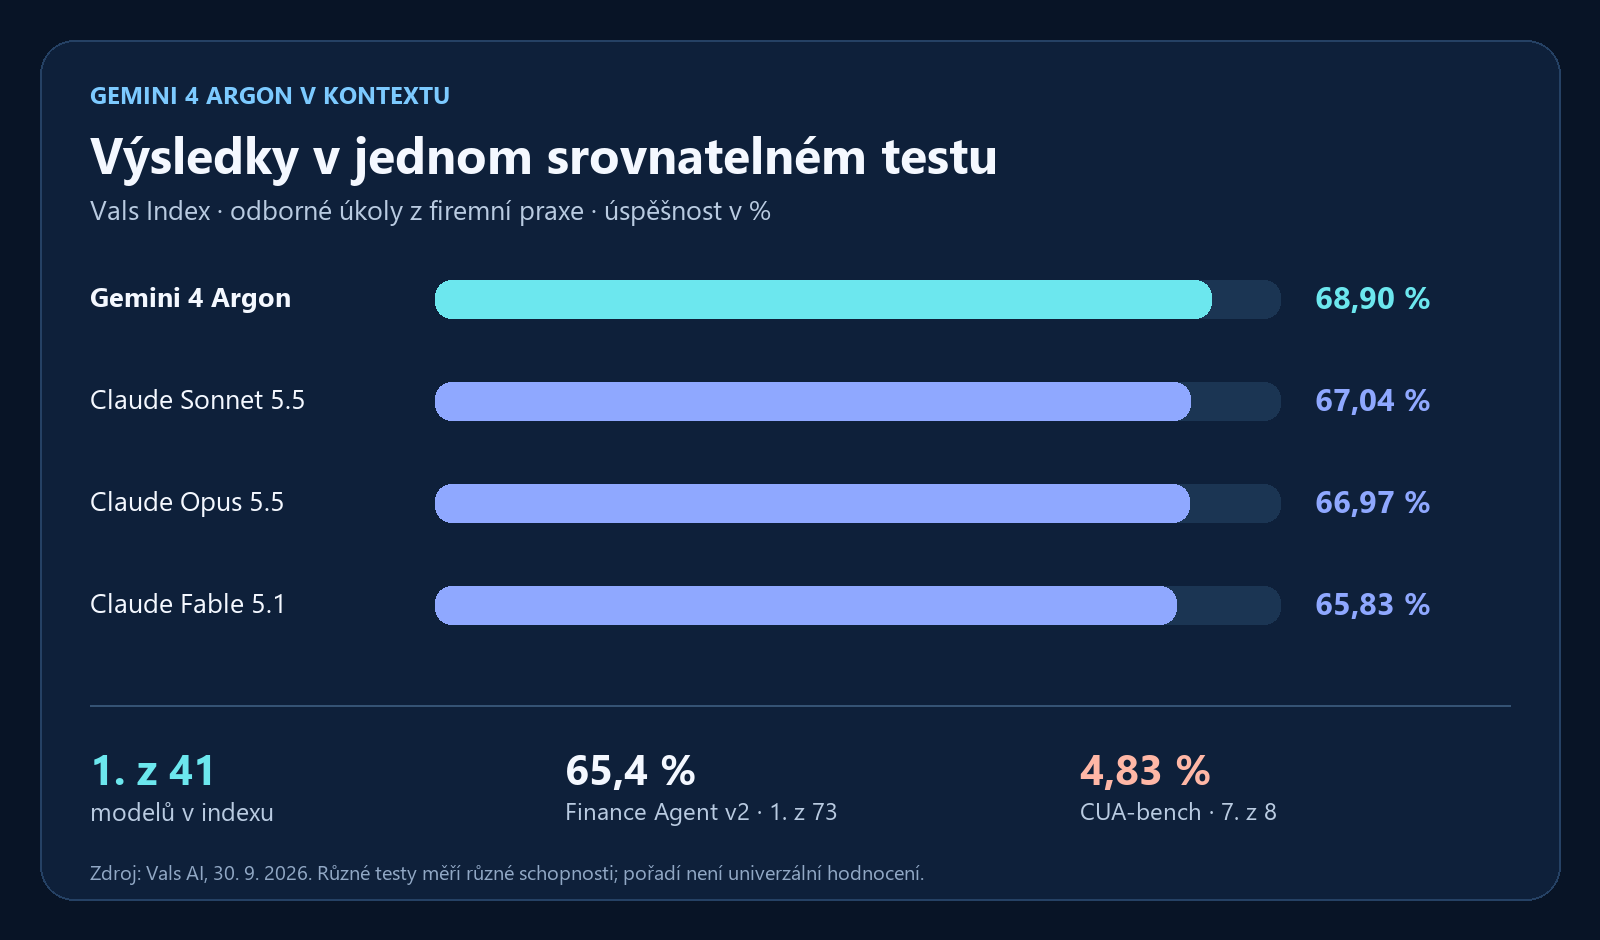
Širší obraz je pestřejší. Vals uvádí pro Argon 1. místo ve Finance Agent v2 (65,40 %), 2. místo v testu migrace kódu (68,17 %) a v CyberBench v1.1 (77,86 %). Naopak v CUA-bench, který sleduje ovládání počítačového prostředí, skončil až 7. z 8 se 4,83 %. V Terminal-Bench 4.0 je 5. ze 42. Takové rozdíly připomínají, že schopnost analyzovat dokumenty není totéž co spolehlivě ovládat aplikace. Zdroj: Vals AI.
Google ve své tabulce hlásí 77,9 % v DeepSWE v1.1, 51,3 % v AutomationBench a 91,7 % v LVBench pro porozumění dlouhému videu. Podle rozboru VentureBeat vede nebo se dělí o první místo ve 13 z 18 zveřejněných srovnání. Ve stejném souboru ale GPT-6 Astra vede na FrontierSWE v2 a Claude Opus 5.5 na Terminal-Bench 4.0. Tato tabulka vychází ze srovnání zveřejněného Googlem; je proto potřeba ji číst vedle nezávislých měření, nikoli jako konečný žebříček. Google; VentureBeat.
Kde může být přínos pro firmy
Vývoj a migrace rozsáhlého kódu
Google popisuje interní použití při ladění a převodu částí velkých projektů z C/C++ do Rustu. U video dekodéru libgav1 podle firmy agenti přepsali přibližně 32 tisíc řádků SIMD kódu a vytvořili řešení 2,7krát rychlejší než předchozí rustová verze při shodném výstupu videa. Je to zajímavý případ práce s měřením výkonu a mnoha iteracemi. Google však současně říká, že podobné zásahy do kritických systémů procházejí automatickými testy i lidským auditem před nasazením. Zdroj: Google.
Finance, právo a podnikové znalosti
U odborné práce může být cenné, že model zvládne spojit více kroků: projít podklady, dohledat rozpory, navrhnout strukturu analýzy a doložit konkrétní pasáže. Výsledek ve Finance Agent v2 je důvodem k testování těchto scénářů. Není ale důkazem, že model může bez kontroly podepsat právní závěr či schválit finanční rozhodnutí. Pro firmu je rozumným cílem nejprve zrychlení přípravy podkladů, zatímco za ověření zdrojů a konečný výrok odpovídá člověk.
Kybernetická obrana
Právě v bezpečnosti začíná omezené zpřístupnění. Google tvrdí, že Argon dokáže nalézt, ověřit a opravit zranitelnosti; společnost Wiz ho podle oznámení využívá v programu Scan for Good. Veřejný popis jednoho nálezu v nemocničním softwaru zatím neposkytuje dost detailů pro nezávislé posouzení závažnosti ani opakovatelnosti. Zajímavý je i bezpečnostní postup: Google slibuje silnější ochranu proti podvrženým instrukcím ve vstupních materiálech a sledování akcí agentů. To je relevantní pro firmy, které chtějí AI připojit k interním systémům. Zdroj: Google.
Dosavadní reakce: nadšení z čísel, výhrada k dostupnosti
První mediální reakce se shodují v jednom omezení: model byl oznámen, ale široká veřejnost ho zatím nemůže nezávisle vyzkoušet. Ars Technica právě omezený přístup staví do středu svého hodnocení. VentureBeat oceňuje šíři výsledků v podnikových úlohách, současně upozorňuje na oblasti, kde vedou konkurenti. Axios připomíná zprávu Bloombergu založenou na anonymních interních zdrojích, podle níž byli někteří zaměstnanci k výkonu skeptičtí; Google toto líčení odmítl. Takové tvrzení je třeba chápat jako spornou zprávu, ne potvrzený závěr o kvalitě modelu. Ars Technica; VentureBeat; Axios.
Debata tedy není jen o tom, kdo má nejvyšší číslo v tabulce. Rozhodující bude konzistence při skutečné práci, cena dlouhých úloh, chybovost a možnost model bezpečně začlenit do provozu. Vals například uvádí u Argonu cenu 15,68 USD za jeden test Vals Indexu, ale u dlouhých agentních úloh částky výrazně rostou. Jeho stránka zároveň ukazuje technické parametry měření, které se liší od Googlu oznámeného maximálního limitu výstupu; před plánováním rozpočtu je proto nutné ověřit dokumentaci konkrétního dostupného tarifu. Zdroj: Vals AI.
Jak model hodnotit, až bude dostupný
- Vyberte vlastní úkoly. Připravte 20 až 30 anonymizovaných případů z jedné agendy, třeba kontrolu smluvních změn, rešerši nebo práci v kódu.
- Předem určete měřítka. Sledujte věcnou správnost, dohledatelnost zdrojů, čas odborníka na opravy, cenu a počet dokončených úloh.
- Srovnejte stejné podmínky. Použijte shodné podklady, oprávnění, časový limit a zadání u Gemini i současného řešení.
- Testujte bezpečnost. Prověřte podvržené instrukce v dokumentech, práci s citlivými daty a možnost zastavit chybný krok agenta.
- Začněte pod lidským dohledem. Teprve po vyhodnocení výsledků rozšiřujte přístup k systémům nebo automatizaci.
Průběžné hodnocení: Gemini 4 Argon má velmi dobrý start v testech odborné práce a komplexního vývoje. Největší otevřenou otázkou zůstává přenos těchto výsledků do běžného provozu a skutečná dostupnost. Firmám dává smysl připravit vlastní pilot, nikoli dnes měnit dodavatele jen podle oznámeného žebříčku.
Napsat komentář